Objetivos y alcance
Una prueba diagnóstica aporta información sobre una condición, pero su resultado necesita interpretarse en relación con lo que se sabía antes de aplicarla. Sensibilidad, especificidad, valores predictivos y razones de verosimilitud responden preguntas diferentes. Confundirlas puede producir diagnósticos injustificados, falsa tranquilidad o estudios adicionales de escaso valor.
Esta clase desarrolla la actualización probabilística mediante ejemplos numéricos originales, lectura crítica de estudios y decisiones clínicas. Los números del ejemplo principal son hipotéticos y se eligen para facilitar el cálculo; no describen la exactitud de una escala concreta. El residente deberá reconstruir una tabla de resultados, calcular probabilidades posteriores, reconocer supuestos y comunicar lo que el resultado permite concluir.
Caso inicial
Un programa universitario utiliza un tamizaje con sensibilidad y especificidad supuestas de 80%. Después de un resultado positivo, un residente afirma que la persona tiene 80% de probabilidad de presentar el trastorno. La conclusión invierte el sentido de una probabilidad condicional. Sensibilidad describe resultados entre personas que tienen la condición; la pregunta clínica solicita la proporción con la condición entre quienes resultaron positivos.
Para responder se necesita una probabilidad previa apropiada y evidencia sobre la prueba en una población comparable. También debe precisarse qué condición se intenta detectar y cuál será la evaluación posterior. No basta conocer que el cuestionario tiene «80% de exactitud»: esa expresión puede ocultar medidas diferentes, umbrales distintos o una muestra que no representa al programa.
El problema se puede resolver sin comenzar por una fórmula abstracta. Las frecuencias naturales permiten mantener visibles los denominadores. Los estudios de Hoffrage y colaboradores muestran que este formato puede facilitar inferencias bayesianas en tareas simples y complejas; ello no elimina la necesidad de comprobar los datos utilizados Hoffrage et al., 2015.
Construcción de una tabla de dos por dos
Supóngase un grupo de 1000 personas en el que 100 tienen la condición según el estándar de referencia y 900 no la tienen. Con sensibilidad de 80%, la prueba identifica a 80 de las 100 personas con la condición y deja 20 resultados falsos negativos. Con especificidad de 80%, identifica correctamente como negativas a 720 de las 900 personas sin la condición y produce 180 falsos positivos.
| Resultado | Condición presente | Condición ausente | Total |
|---|---|---|---|
| Positivo | 80 | 180 | 260 |
| Negativo | 20 | 720 | 740 |
| Total | 100 | 900 | 1000 |
Hay 260 resultados positivos, de los cuales 80 corresponden a personas con la condición: 80 dividido por 260 es aproximadamente 30,8%. Ese es el valor predictivo positivo del ejemplo. Entre los 740 negativos, 720 no tienen la condición: el valor predictivo negativo es aproximadamente 97,3%. La probabilidad de condición presente después de un negativo es 20 dividido por 740, aproximadamente 2,7%.
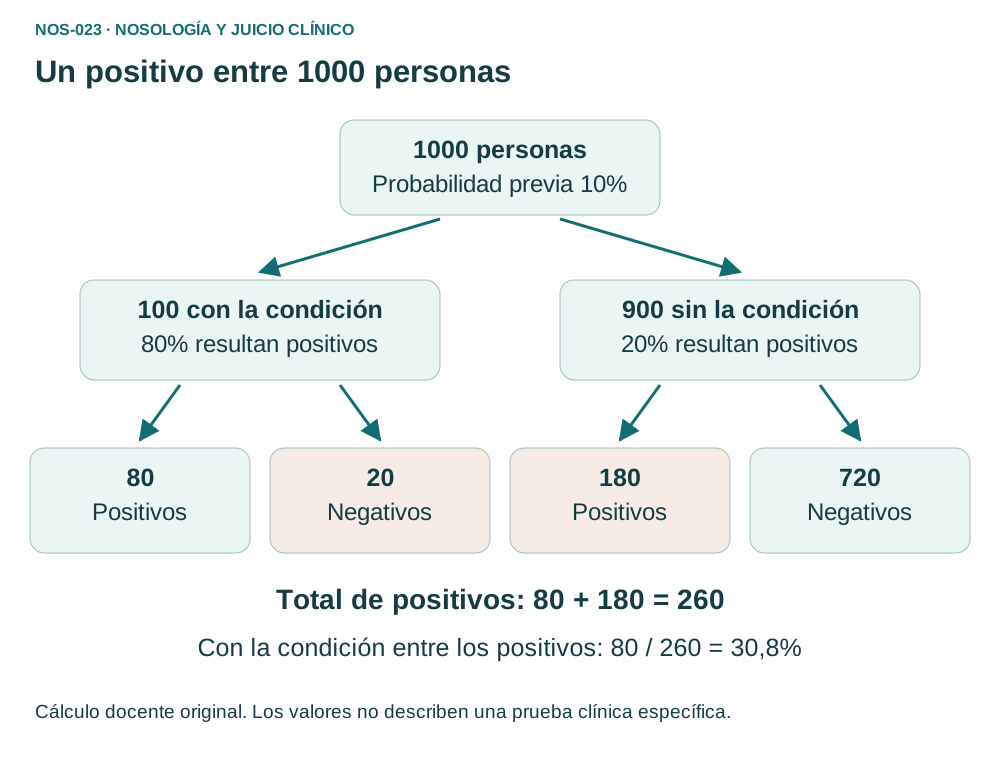
Figura 1. Ejemplo hipotético original. Sensibilidad y especificidad se mantienen en 80%; la probabilidad previa es 10%. Las cantidades representan frecuencias esperadas bajo esos supuestos.
La expresión «falso positivo» se refiere a discordancia con la condición definida por el estándar. No significa que la persona carezca de sufrimiento o de otra necesidad de atención. Un programa debe contar con evaluación posterior para comprender qué ocurre en quienes superan el umbral, incluyendo situaciones que el diagnóstico objetivo no describe completamente.
Mantener explícitos los denominadores
Sensibilidad es la proporción de positivos entre quienes tienen la condición. Especificidad es la proporción de negativos entre quienes no la tienen. El valor predictivo positivo es la proporción con la condición entre los positivos, mientras que el negativo es la proporción sin ella entre los negativos. Las palabras «entre quienes» permiten identificar qué grupo funciona como denominador.
En el ejemplo, el 20% complementario de la especificidad no significa que solo 20% de los positivos sean falsos. Significa que 20% de las personas sin la condición resultan positivas. Como ese grupo es grande, aporta 180 resultados y supera a los 80 verdaderos positivos. La proporción de falsos entre los positivos es aproximadamente 69,2%.
Tampoco debe confundirse exactitud global con sensibilidad. En esta tabla, 800 de 1000 clasificaciones son correctas, pero esa cifra resume verdaderos positivos y verdaderos negativos sin mostrar sus consecuencias. Dos pruebas con igual proporción global de aciertos pueden cometer errores muy diferentes. Para una decisión clínica se necesitan las medidas pertinentes y el contexto de aplicación.
Probabilidad previa y población de referencia
La probabilidad preprueba integra frecuencia de la condición en una población comparable y datos clínicos disponibles antes del resultado. No es siempre idéntica a la prevalencia poblacional. Una persona derivada por síntomas específicos puede tener una probabilidad diferente de la de todos los estudiantes de la universidad. Debe indicarse de dónde proviene la estimación y qué información ya incorpora.
Si no existe una estimación precisa, puede utilizarse un intervalo razonado para explorar cómo cambian las conclusiones. Presentar una cifra con varios decimales no corrige una base incierta. Es preferible mostrar que, bajo distintas probabilidades previas plausibles, el resultado sigue justificando evaluación adicional, o que la conducta sería sensible a esa incertidumbre.
La población de referencia también puede estar afectada por selección. Quienes acceden a una consulta especializada no representan automáticamente a quienes no consultan. Diferencias de acceso, derivación o gravedad influyen en la composición del grupo. Estas cuestiones deben considerarse antes de trasladar estimaciones, sin convertir características sociales en sustitutos injustificados de una evaluación individual.
Razones de verosimilitud y actualización
La razón de verosimilitud positiva compara la probabilidad de un resultado positivo entre personas con y sin la condición. Se calcula como sensibilidad dividida por uno menos especificidad. La negativa compara la probabilidad de un negativo en esos mismos grupos: uno menos sensibilidad dividido por especificidad. Estas medidas permiten actualizar las odds previas McGee, 2002.
Para evitar confusiones, pueden escribirse las operaciones por separado:
- Odds preprueba = probabilidad preprueba / (1 − probabilidad preprueba).
- Odds posprueba = odds preprueba × razón de verosimilitud del resultado.
- Probabilidad posprueba = odds posprueba / (1 + odds posprueba).
En el ejemplo, RV positiva = 0,80 / 0,20 = 4 y RV negativa = 0,20 / 0,80 = 0,25. Una probabilidad previa de 0,10 corresponde a odds de 1/9. Después de un positivo, las odds son 4/9 y la probabilidad es 4/13, aproximadamente 30,8%. Después de un negativo, las odds son 1/36 y la probabilidad es 1/37, aproximadamente 2,7%.
Multiplicar directamente 10% por cuatro y anunciar 40% sería incorrecto: la operación se realiza sobre odds, no sobre probabilidad. Tampoco «cuatro veces» significa que el resultado sea cuatro veces más grave. La razón expresa cuánto se espera ese resultado bajo dos estados definidos de la condición, dentro de las condiciones en que fue estimada.
Una RV cercana a uno aporta poca discriminación para esa comparación. Una RV mayor que uno aumenta las odds y una menor que uno las reduce. La magnitud clínicamente suficiente depende del punto de partida y de la decisión; no existe un valor que confirme o excluya toda enfermedad en cualquier contexto.
La misma prueba en probabilidades previas diferentes
Manteniendo las mismas razones de verosimilitud, una probabilidad previa de 1% aumenta a aproximadamente 3,9% tras un positivo. Una de 10% aumenta a 30,8%, y una de 50% aumenta a 80%. La diferencia no se debe a que se haya cambiado el resultado: cambia la información previa con la que se combina.
| Probabilidad previa | Después de un positivo | Después de un negativo |
|---|---|---|
| 1% | 3,9% | 0,3% |
| 10% | 30,8% | 2,7% |
| 50% | 80,0% | 20,0% |
| 90% | 97,3% | 69,2% |
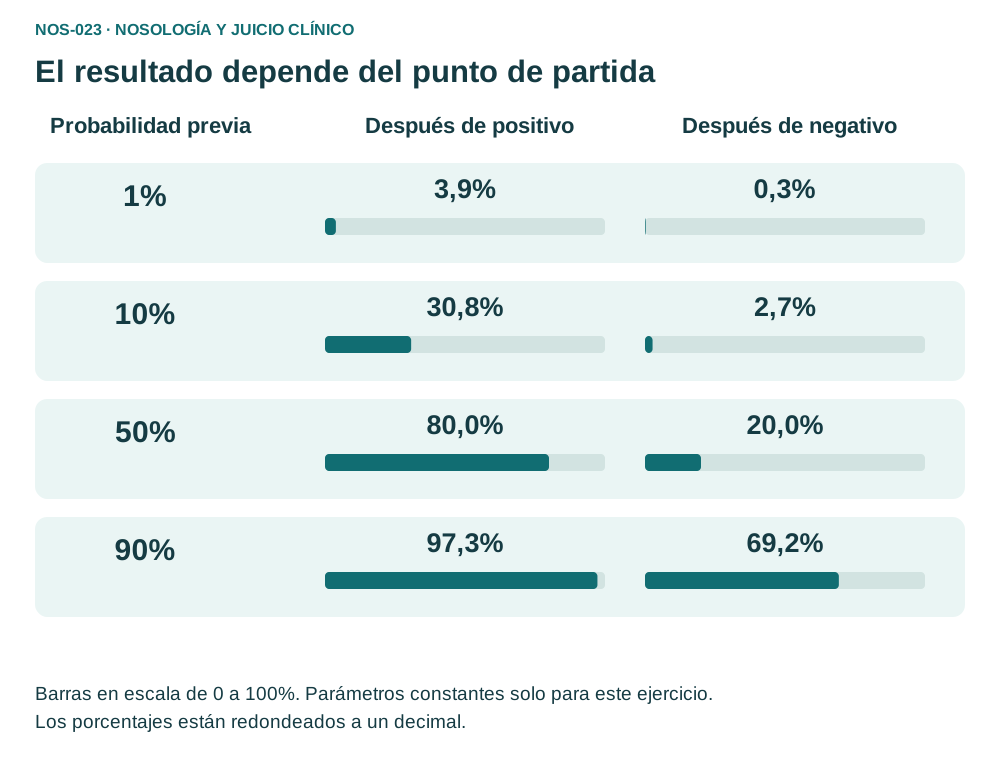
Figura 2. Comparación numérica original. Un negativo puede dejar una probabilidad alta si el punto de partida era alto. Los parámetros de la prueba se mantienen constantes solo para este ejercicio.
El último renglón muestra por qué un negativo no siempre cierra la investigación. Si la probabilidad previa era 90%, la prueba supuesta la reduce a 69,2%, que puede seguir requiriendo atención o estudios. A la inversa, un positivo en una población de probabilidad muy baja puede dejar una probabilidad pequeña. La utilidad depende de cuánto cambia una decisión razonada.
Exactitud estimada y transportabilidad
Sensibilidad y especificidad no son propiedades absolutamente fijas. Pueden variar con el espectro clínico, la selección de participantes, el punto de corte, la administración y la definición del estándar de referencia. STARD solicita información que permita reconocer estos aspectos y evaluar la aplicabilidad de un estudio Bossuyt et al., 2015.
Un estudio que compara casos muy característicos con personas sanas puede estimar una discriminación mayor que la observada entre pacientes con síntomas superpuestos. La pregunta de la consulta suele ser cuál explicación es más adecuada entre alternativas plausibles, no si un caso grave se diferencia de una persona sin síntomas. Antes de utilizar una cifra debe comprobarse qué contraste evaluó el estudio.
La precisión estadística también importa. Una estimación puntual puede tener un intervalo amplio si hay pocos participantes con la condición. Si el estudio incluye muchas personas pero muy pocos casos, el tamaño total no garantiza buena precisión de sensibilidad. Al interpretar una revisión, deben considerarse incertidumbre y heterogeneidad, además del promedio publicado.
Los resultados del PHQ-9 ilustran la importancia del referente: un metaanálisis con datos individuales encontró diferencias en sensibilidad según el tipo de entrevista diagnóstica empleada. Una cifra aislada sin esa información puede sugerir una uniformidad inexistente Negeri et al., 2021. La lección es metodológica y no implica que la prueba sea inútil.
El estándar de referencia también necesita evaluación
En psiquiatría, una entrevista diagnóstica puede ser el mejor referente disponible para una categoría y mantener limitaciones. La concordancia con esa entrevista no equivale a identificar una lesión o un mecanismo biológico. Debe precisarse qué categoría, período y procedimiento se utilizaron, así como entrenamiento y acceso a información adicional.
Existe sesgo de incorporación cuando el resultado de la prueba evaluada forma parte del procedimiento que determina la condición de referencia, comprometiendo la independencia de la comparación. Esto no es idéntico a que ambos instrumentos pregunten por síntomas semejantes: el solapamiento de contenido requiere análisis, pero no demuestra por sí solo incorporación. Es importante revisar cómo se obtuvo realmente la clasificación final.
También pueden surgir problemas si solo los positivos reciben verificación, si se utilizan referentes distintos según el resultado o si transcurre suficiente tiempo para que cambie la condición. La evaluación crítica necesita reconstruir el flujo de participantes. Los datos excluidos y resultados indeterminados deben ser visibles para entender qué población quedó en el análisis.
QUADAS-3, publicado en febrero de 2026, actualiza la evaluación de riesgo de sesgo y aplicabilidad de estudios de exactitud. Introduce valoraciones al nivel de las estimaciones y explicita preguntas de síntesis y un estudio ideal de referencia para orientar la evaluación. Su finalidad es metodológica; no entrega por sí mismo la probabilidad diagnóstica de un paciente Whiting et al., 2026.
Resultados continuos y puntos de corte
Muchas medidas producen un rango de valores antes de transformarse en positivas o negativas. El corte simplifica decisiones, pero elimina información. Dos personas con valores apenas por debajo y por encima del umbral pueden ser más semejantes entre sí que dos personas que superan el corte con puntajes muy distintos.
Cuando existen razones de verosimilitud para intervalos de resultados y son aplicables, pueden permitir una actualización más informativa que la dicotomía. No corresponde inventarlas a partir de una impresión de gravedad. Si solo se conoce la exactitud de un umbral, debe respetarse el alcance de esa evidencia y evitar atribuir probabilidades precisas a cada puntaje individual.
La elección del umbral tampoco se resuelve exclusivamente maximizando una medida estadística. Los costos de falsos positivos y negativos, los recursos y el propósito clínico pueden ser diferentes. Una clasificación útil para seleccionar evaluación posterior no necesariamente tiene el balance apropiado para iniciar una intervención con riesgos importantes.
Combinar datos sin contarlos dos veces
La actualización secuencial requiere considerar dependencia. Dos cuestionarios que preguntan por síntomas muy semejantes no constituyen automáticamente dos pruebas independientes. Multiplicar sus razones de verosimilitud como si lo fueran puede producir una confianza excesiva. Para hacerlo correctamente se necesitan razones condicionadas a la información previa o modelos conjuntos adecuadamente evaluados.
El mismo problema aparece dentro de la entrevista. Si la probabilidad preprueba ya incorporó insomnio, ánimo bajo y anhedonia, no deben volver a contarse como evidencia enteramente nueva al interpretar un cuestionario construido con esos elementos. La pregunta es qué información adicional aporta el resultado más allá de lo conocido.
Un ejemplo hipotético es una derivación basada en un cuestionario positivo seguida de una segunda aplicación del mismo formulario sin cambios clínicos relevantes. Dos resultados semejantes pueden apoyar la estabilidad de las respuestas, pero no equivalen a dos confirmaciones etiológicas independientes. El siguiente paso debe aportar información pertinente, como curso, exclusiones o evaluación del síndrome.
Varias hipótesis y diagnósticos coexistentes
Un resultado puede discriminar síntomas depresivos frente a ausencia de ellos y aportar poco para distinguir un episodio depresivo bipolar de uno unipolar. La condición objetivo de la prueba debe corresponder a la pregunta del diferencial. Una prueba de detección de depresión no se convierte en prueba de polaridad por utilizarse en una consulta psiquiátrica.
Además, las hipótesis no siempre son mutuamente excluyentes. Depresión y consumo problemático pueden coexistir. En ese caso no corresponde repartir automáticamente un total de 100% entre ambos diagnósticos como si solo uno pudiera estar presente. La modelización probabilística debe representar la estructura real de la pregunta y las posibilidades de comorbilidad.
Cuando las categorías sí son excluyentes y exhaustivas, sus probabilidades deben ser coherentes entre sí. Pero el diferencial clínico suele incluir hipótesis de niveles distintos, como síndrome, causa y comorbilidad. Antes de asignar números, es necesario ordenar esos niveles y precisar qué evento representa cada probabilidad.
De la probabilidad a la decisión
La probabilidad es un componente de la conducta, junto con beneficios y daños de actuar, esperar o investigar. El modelo de umbrales de Pauker y Kassirer distingue regiones en las que puede ser razonable no realizar una intervención específica, obtener información adicional o actuar sin otra prueba. Los límites dependen de las consecuencias y propiedades de las opciones Pauker y Kassirer, 1980.
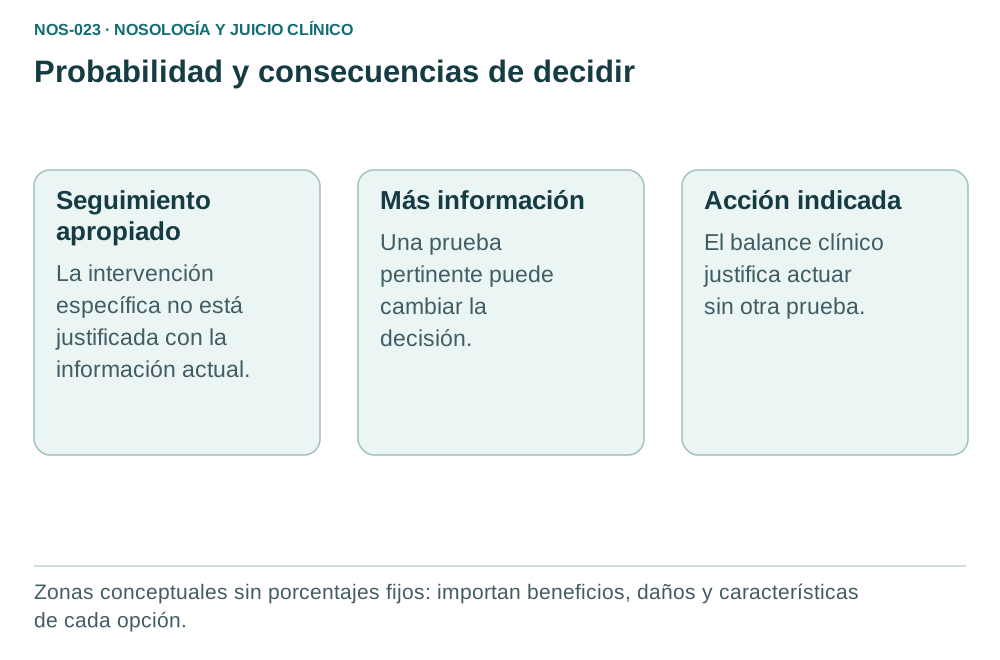
Figura 3. Esquema docente original inspirado en el análisis de umbrales. La posición de los límites depende de la decisión concreta y no se fija mediante porcentajes universales.
No existe un único porcentaje que autorice cualquier tratamiento psiquiátrico. Una conversación de evaluación, un examen invasivo y un fármaco de riesgo tienen consecuencias diferentes. Incluso si la probabilidad de una condición es baja, la gravedad de omitirla puede justificar estudio dirigido. Esto no implica investigar todas las posibilidades remotas sin considerar rendimiento y efectos adversos.
En el programa universitario, un positivo puede justificar entrevista adicional aunque todavía no sustente un diagnóstico. La intervención adecuada corresponde a esa etapa del proceso. Comunicar el resultado como enfermedad confirmada añade una conclusión que el cálculo no respalda y puede producir efectos personales y asistenciales innecesarios.
Ejercicio adicional sobre especificidad y baja frecuencia
Considérese ahora un grupo hipotético de 10 000 personas con probabilidad previa de 1%. Hay 100 personas con la condición y 9900 sin ella. Una prueba con sensibilidad de 80% y especificidad de 99% produciría 80 verdaderos positivos y 99 falsos positivos. Entre los 179 positivos, aproximadamente 44,7% tendrían la condición. Incluso con esa especificidad elevada, el resultado positivo todavía requiere interpretación y evaluación posterior.
Este ejemplo no demuestra que tamizar sea inadecuado ni establece cuál prueba debería utilizar el programa. Muestra una consecuencia matemática de los supuestos. Para valorar un programa se necesitan además beneficios de detección, posibilidades de atención, daños y costos, así como evidencia sobre la condición y el instrumento concretos. La exactitud es una parte de esa evaluación.
La comparación con la prueba de especificidad de 80% ayuda a reconocer el papel de los falsos positivos. En el mismo grupo de 10 000 personas, esa prueba produciría 1980 falsos positivos y conservaría 80 verdaderos positivos si la sensibilidad no cambiara. El valor predictivo positivo sería 80 dividido por 2060, aproximadamente 3,9%. Mantener sensibilidad constante mientras se modifica especificidad es un supuesto docente; en una prueba real, cambiar el umbral suele modificar ambas.
El ejercicio también permite explicar por qué no basta anunciar «muy pocos falsos positivos» sin identificar el denominador. Una tasa pequeña aplicada a una población muy numerosa sin la condición puede producir una cantidad relevante de evaluaciones adicionales. El programa necesita prever esa demanda y comunicar el significado del resultado con precisión.
Revisión práctica de un cálculo recibido
Antes de aceptar una probabilidad informada por una calculadora o un sistema digital, el clínico debe revisar sus entradas. Primero identifica la condición objetivo y el resultado que se está actualizando. Después comprueba la fuente de la probabilidad previa, el umbral y las estimaciones de exactitud. Finalmente verifica si se incorporó información que ya estaba incluida en el punto de partida.
Si el sistema muestra 82,37%, conviene preguntar si los datos permiten ese nivel de precisión. La presentación decimal puede provenir simplemente de una operación aritmética sobre estimaciones aproximadas. Deben conservarse los límites de los parámetros, incluyendo la posibilidad de que no sean transportables al paciente. El cálculo correcto no transforma un supuesto débil en una observación clínica sólida.
Cuando no se conoce con precisión la probabilidad previa, puede repetirse el cálculo con varios valores plausibles. Si todos llevan a la misma decisión, esa conducta puede ser relativamente robusta frente a la incertidumbre considerada. Si pequeñas diferencias cambian la decisión, es necesario reconocerlo y valorar información adicional. Esta exploración no elimina la incertidumbre, pero permite localizar qué supuesto importa para la acción.
Comunicación y registro clínico
La explicación al paciente debe mantener visible qué se encontró y qué falta por establecer. Puede indicarse que el resultado identifica síntomas que merecen evaluación, que algunas personas con ese resultado tienen la condición buscada y otras presentan situaciones diferentes. Si se usan cifras, deben corresponder a evidencia aplicable y expresarse con denominadores claros.
En el registro técnico conviene consignar la fuente de la probabilidad previa, el resultado, los parámetros utilizados y su incertidumbre cuando se realizó un cálculo. No siempre se dispone de información suficiente para una estimación numérica formal. En ese caso puede explicarse cualitativamente cómo cambia la hipótesis, sin inventar una precisión inexistente.
Una conclusión bien delimitada podría ser: «Tamizaje positivo que aumenta la sospecha; exactitud local no establecida; se requiere entrevista diagnóstica y evaluación del funcionamiento». Esta formulación no desestima el resultado. Lo ubica dentro de una secuencia que permitirá decidir con información más pertinente.
Autoevaluación razonada
¿80% de sensibilidad significa 80% de probabilidad después de un positivo? No. Los denominadores son distintos; se necesita integrar la probabilidad previa y la especificidad.
¿Qué ocurre con un negativo si la probabilidad previa era muy alta? Puede reducirla sin llevarla a un nivel suficiente para cerrar la evaluación, como muestra el ejemplo de 90% a 69,2%.
¿Pueden multiplicarse razones de dos pruebas semejantes? Solo con supuestos de independencia condicional apropiados o estimaciones que incorporen su dependencia; hacerlo mecánicamente puede duplicar información.
¿Una probabilidad determina por sí sola el tratamiento? No. Deben considerarse consecuencias, alternativas, preferencias y valor de obtener información adicional.
Referencias seleccionadas
- Hoffrage U, Krauss S, Martignon L, Gigerenzer G. Natural frequencies improve Bayesian reasoning in simple and complex inference tasks. Frontiers in Psychology. 2015;6:1473. Estudio y DOI 10.3389/fpsyg.2015.01473.
2. McGee S. Simplifying likelihood ratios. Journal of General Internal Medicine. 2002;17(8):646–649. Artículo y DOI 10.1046/j.1525-1497.2002.10750.x.
3. Bossuyt PM, Reitsma JB, Bruns DE, et al. STARD 2015: an updated list of essential items for reporting diagnostic accuracy studies. BMJ. 2015;351:h5527. Declaración y DOI 10.1136/bmj.h5527.
4. Negeri ZF, Levis B, Sun Y, et al. Accuracy of the Patient Health Questionnaire-9 for screening to detect major depression: updated systematic review and individual participant data meta-analysis. BMJ. 2021;375:n2183. Metaanálisis y DOI 10.1136/bmj.n2183.
5. Whiting PF, Tomlinson E, Rutjes AWS, et al. QUADAS-3: A Revised Tool for the Quality Assessment of Diagnostic Test Accuracy Studies. Annals of Internal Medicine. 2026. DOI 10.7326/ANNALS-25-02104. Herramienta y documentación de la Universidad de Bristol.
6. Pauker SG, Kassirer JP. The threshold approach to clinical decision making. New England Journal of Medicine. 1980;302(20):1109–1117. Artículo y DOI 10.1056/NEJM198005153022003.
Jonathan Alarcón C., ed. Interpretación probabilística de pruebas. Docencia en Psiquiatría. Revisión 24.09.2026. https://portal-docencia-psiquiatria-uc-hlf.pages.dev/becados/nosologia-juicio-clinico/interpretacion-probabilistica-de-pruebas/