Objetivos de aprendizaje
Los instrumentos clínicos permiten recoger información de manera sistemática, comparar observaciones y seguir cambios. Su utilidad depende de que la interpretación corresponda al propósito, la población y las condiciones de aplicación. Un puntaje puede ayudar a reconocer síntomas relevantes sin establecer por sí solo un diagnóstico; una disminución puede representar mejoría sin demostrar recuperación; una medición confiable puede ser poco adecuada para la pregunta que se intenta responder.
Al terminar esta clase, el residente deberá seleccionar instrumentos según su finalidad, revisar sus principales propiedades de medición, interpretar resultados junto con la entrevista y organizar un seguimiento que conecte datos con decisiones. El objetivo no es oponer escalas y juicio clínico. Ambos pueden contener errores y ambos deben someterse a evaluación crítica cuando no concuerdan.
Caso inicial
Una mujer obtiene 17 puntos en el PHQ-9. El residente registra «trastorno depresivo mayor moderadamente grave» y propone tratamiento antes de explorar episodios de activación, consumo de sustancias, enfermedades médicas o el curso completo. El error consiste en convertir una puntuación en varias conclusiones distintas: categoría diagnóstica, polaridad, gravedad integral e indicación terapéutica.
En la interpretación original del PHQ-9, 17 puntos se sitúan en el intervalo de síntomas descrito como moderadamente grave. El instrumento recoge frecuencia de síntomas durante las dos semanas previas y fue estudiado tanto para gravedad como para identificación de depresión Kroenke et al., 2001. No debe presentarse como una herramienta que solo sirve para tamizaje, pero tampoco como un reemplazo de la evaluación clínica completa.
El puntaje requiere revisar las respuestas individuales, las condiciones de aplicación y la interferencia funcional. Debe comprobarse si la paciente comprendió las preguntas y si los síntomas constituyen un episodio con una explicación diagnóstica sustentada. El total no revela por sí mismo qué combinación de síntomas lo produjo ni cuáles necesitan atención inmediata.
Propósito antes que nombre del instrumento
Un mismo cuestionario puede utilizarse para más de una finalidad, siempre que exista evidencia y un procedimiento adecuado para cada uso. La distinción relevante es qué inferencia se quiere hacer. Identificar personas que requieren evaluación, comprobar criterios, estimar gravedad y observar evolución son tareas relacionadas, pero no equivalentes.
| Finalidad | Pregunta | Límite principal |
|---|---|---|
| Tamizaje | ¿Quién requiere evaluación adicional? | Un positivo no confirma automáticamente una categoría |
| Entrevista diagnóstica | ¿Cómo se cumplen requisitos y exclusiones? | La estandarización no elimina problemas de interpretación |
| Gravedad sintomática | ¿Cuál es la intensidad o frecuencia medida? | No representa toda la situación clínica |
| Funcionamiento | ¿Qué dificultades existen en actividades y participación? | No identifica necesariamente su causa |
| Seguimiento | ¿Qué cambió y qué decisión orienta? | Todo cambio observado contiene incertidumbre |
Antes de aplicar un instrumento conviene formular una frase operativa: «Se utilizará para establecer una línea basal de síntomas durante el seguimiento». Esa formulación delimita su papel. Si luego se utiliza el resultado para decidir un alta o establecer una incapacidad, aparece una inferencia adicional que necesita justificación propia y no queda autorizada por la utilidad inicial del instrumento.
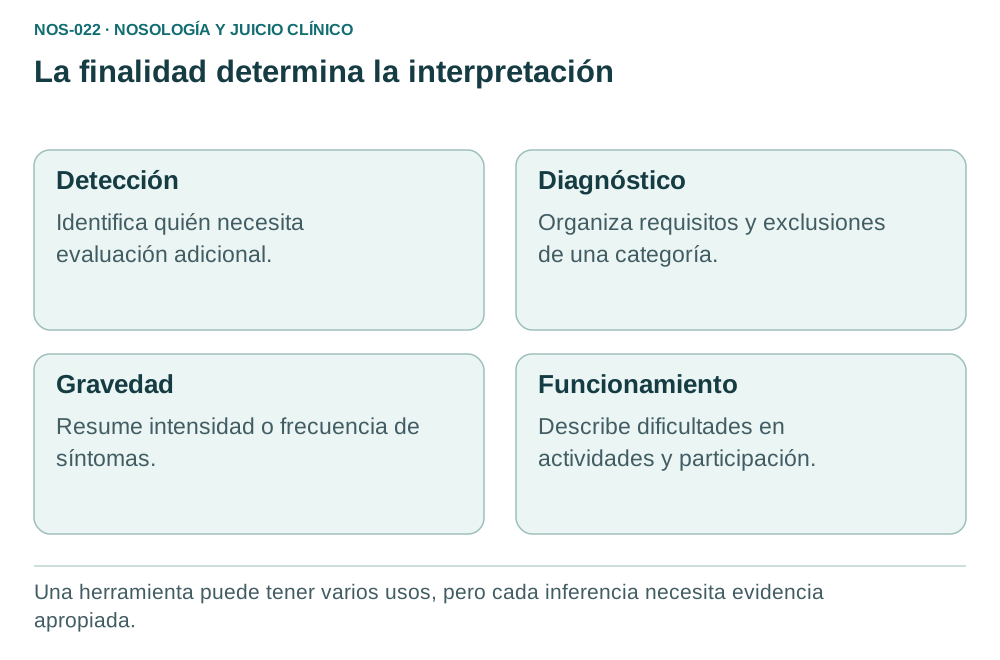
Figura 1. Organización original de finalidades. El seguimiento puede utilizar medidas de varios dominios; sus puntuaciones conservan significados diferentes.
Tamizaje y evaluación posterior
El tamizaje selecciona personas con mayor posibilidad de presentar una condición para realizar una evaluación posterior. La elección de un punto de corte expresa un equilibrio entre resultados falsos positivos y falsos negativos. No todos los programas privilegian la sensibilidad de la misma manera: también importan consecuencias, recursos, población y posibilidad real de completar la evaluación.
En el metaanálisis actualizado del PHQ-9, la exactitud varió según el tipo de entrevista utilizado como referencia. Para el umbral habitual de 10 y entrevistas semiestructuradas, las estimaciones combinadas de sensibilidad y especificidad fueron aproximadamente 85%. Son resultados de conjuntos de estudios, no propiedades exactas e invariables en cualquier consulta Negeri et al., 2021.
El valor predictivo de un resultado depende también de la probabilidad previa de la condición. Por ello, un cuestionario aplicado en población general y el mismo cuestionario aplicado en una consulta especializada pueden generar proporciones diferentes de verdaderos positivos. La interpretación probabilística se desarrolla en el capítulo siguiente; aquí interesa evitar que un umbral se trate como una frontera natural entre enfermedad y salud.
Un resultado negativo puede ser insuficiente cuando la entrevista aporta signos relevantes. Deben revisarse el período preguntado, la comprensión y la presentación clínica, sin asumir que existe ocultamiento deliberado. La discrepancia puede reflejar un instrumento inadecuado, una entrevista incompleta o diferencias de contexto. Elegir de antemano cuál fuente es correcta impide investigar esa discordancia.
Entrevistas estructuradas y semiestructuradas
Las entrevistas diagnósticas estandarizan preguntas y reglas de clasificación. Algunas están diseñadas para aplicación por entrevistadores entrenados siguiendo secuencias fijas; otras permiten al clínico explorar y valorar respuestas. No deben agruparse como si todas midieran de la misma manera. La comparación de instrumentos necesita atender al procedimiento de referencia utilizado, como muestra la variación observada en estudios del PHQ-9 Negeri et al., 2021.
La estandarización ayuda a reducir omisiones, pero no resuelve automáticamente la fenomenología. Una respuesta afirmativa a una pregunta sobre pensamientos acelerados puede referirse a preocupación, activación afectiva o una experiencia difícil de describir. Se requiere aplicar las reglas del instrumento sin agregar supuestos personales y, cuando corresponda, complementar la entrevista para comprender el fenómeno.
El entrenamiento incluye reconocer qué puede aclararse sin alterar el procedimiento. Cambiar ejemplos, períodos o criterios de puntuación de manera improvisada puede comprometer la comparabilidad. Cuando la administración debió adaptarse, la modificación se documenta y su efecto sobre la interpretación se considera explícitamente. La apariencia de un formulario completo no garantiza que la evaluación haya sido válida.
Propiedades de medición que deben distinguirse
COSMIN organiza propiedades como validez de contenido, estructura, confiabilidad, error de medición y capacidad de detectar cambios. Estas dimensiones no son intercambiables: evidencia favorable para una no demuestra las demás Mokkink et al., 2010. Para uso clínico interesa conocer qué evidencia existe en personas semejantes a quienes serán evaluadas y para la interpretación concreta que se pretende realizar.
La validez de contenido pregunta si los elementos representan adecuadamente el constructo. La confiabilidad se relaciona con consistencia bajo condiciones especificadas; el error de medición indica cuánto puede variar el resultado por razones distintas de un cambio real. La capacidad de detectar cambio requiere que el instrumento sea sensible a modificaciones del dominio medido durante el seguimiento.
Un ejemplo docente permite distinguirlas. Una escala puede producir resultados muy similares en dos aplicaciones cercanas y aun así omitir un dominio importante para el paciente. Otra puede cubrir aspectos pertinentes, pero mostrar variabilidad que dificulta interpretar pequeñas diferencias individuales. La selección exige conocer ese perfil, no limitarse a buscar que el artículo use el adjetivo «validado».
| Propiedad o condición | Pregunta práctica |
|---|---|
| Contenido | ¿Incluye los aspectos relevantes y comprensibles para esta población? |
| Confiabilidad | ¿Qué estabilidad o acuerdo se demostró, bajo qué condiciones? |
| Error de medición | ¿Qué magnitud de variación puede aparecer sin cambio real? |
| Validez de constructo | ¿Las relaciones observadas concuerdan con hipótesis justificadas? |
| Capacidad de detectar cambio | ¿Puede reflejar modificaciones del dominio durante el seguimiento? |
La utilidad también depende de tiempo, accesibilidad y carga de aplicación. Un instrumento muy extenso puede resultar inviable para mediciones frecuentes; uno breve puede omitir detalles necesarios en una evaluación especializada. Estas decisiones son explícitas y revisables, sin presumir que mayor longitud equivale a mayor calidad.
Población, idioma y condiciones de administración
Una traducción no demuestra equivalencia cultural ni propiedades psicométricas suficientes. Debe verificarse la versión utilizada, el grupo etario, la modalidad de administración y el contexto de validación. La lectura asistida, la aplicación telefónica o el cambio de informante pueden ser apropiados, pero su comparabilidad requiere evidencia o al menos reconocer la limitación introducida.
Antes de interpretar un total, conviene revisar respuestas omitidas, marcaciones múltiples y dificultades de comprensión. Los datos faltantes se manejan según el manual; no deben transformarse automáticamente en ausencia de síntomas. Si un paciente dejó un ítem sin responder porque no comprendió una palabra, asignar cero modifica el significado de la medición.
También debe respetarse la ventana temporal. Preguntar por la última semana cuando el instrumento indica dos semanas produce un dato diferente. Repetirlo a diario puede generar períodos ampliamente superpuestos y aparentar una precisión temporal que el cuestionario no tiene. La frecuencia debe corresponder a su diseño y a la pregunta clínica, además de la velocidad esperada de cambio.
La ficha debe identificar instrumento, versión, fecha, informante y condiciones relevantes. Esta información permite entender diferencias posteriores. Si una primera puntuación fue autoadministrada y la siguiente completada por un familiar, no conviene unirlas en una misma curva sin señalar el cambio de fuente.
Qué representa un puntaje total
Una suma resume respuestas mediante una regla. No convierte automáticamente el constructo en una entidad única ni identifica un mecanismo causal. Dos personas pueden obtener el mismo total con perfiles distintos, y una misma persona puede mantener el total mientras cambian síntomas relevantes. El análisis de ítems complementa la lectura global cuando las decisiones dependen de dominios específicos.
Un ejemplo hipotético es la combinación de mejor sueño y mayor desesperanza, con una suma final similar a la anterior. Describir el caso como «sin cambios» omitiría información importante. La interpretación debe preguntar qué mejoró, qué empeoró y qué necesita atención, además de comparar el total.
La estructura factorial o la consistencia interna tampoco resuelven por sí solas la ontología del trastorno. Son resultados sobre patrones de respuestas bajo determinados supuestos. Inferir una enfermedad latente específica o una relación causal entre síntomas requiere teoría y evidencia adicional. Esta distinción filosófica tiene una consecuencia clínica: la puntuación orienta una representación del estado, sin sustituir la explicación del caso.
Cambio observado, confiable y relevante
El cambio observado es la diferencia entre mediciones. El cambio confiable intenta establecer si esa diferencia excede la variación esperable por error, bajo un modelo determinado. La importancia clínica pregunta si el cambio resulta relevante para síntomas, funcionamiento o metas. Estas cuestiones no se resuelven con una única comparación numérica.
Jacobson y Truax propusieron un índice de cambio confiable y una manera de combinarlo con criterios de significación clínica basados en distribuciones de referencia. Es un enfoque específico, con supuestos y datos requeridos; no una regla universal que permita asignar el mismo umbral a cualquier instrumento Jacobson y Truax, 1991.
La diferencia mínima importante y el cambio detectable tampoco son sinónimos. Un cambio valorado por el paciente puede ser pequeño respecto de la incertidumbre de una medición individual. A la inversa, una diferencia estadísticamente distinguible del error puede tener escasa importancia práctica. La interpretación necesita reconocer ambos aspectos y no convertir un umbral publicado para un contexto en una constante aplicable a todos.
Supóngase una escala hipotética que disminuye de 18 a 14 puntos. Sin conocer sus propiedades, no se puede afirmar que cuatro puntos representan recuperación. Se requieren el dominio medido, la precisión, la trayectoria y la experiencia del paciente. Si además el funcionamiento mejora, esa convergencia aporta información; si empeora, la discordancia merece evaluación y no debe ocultarse bajo el promedio.
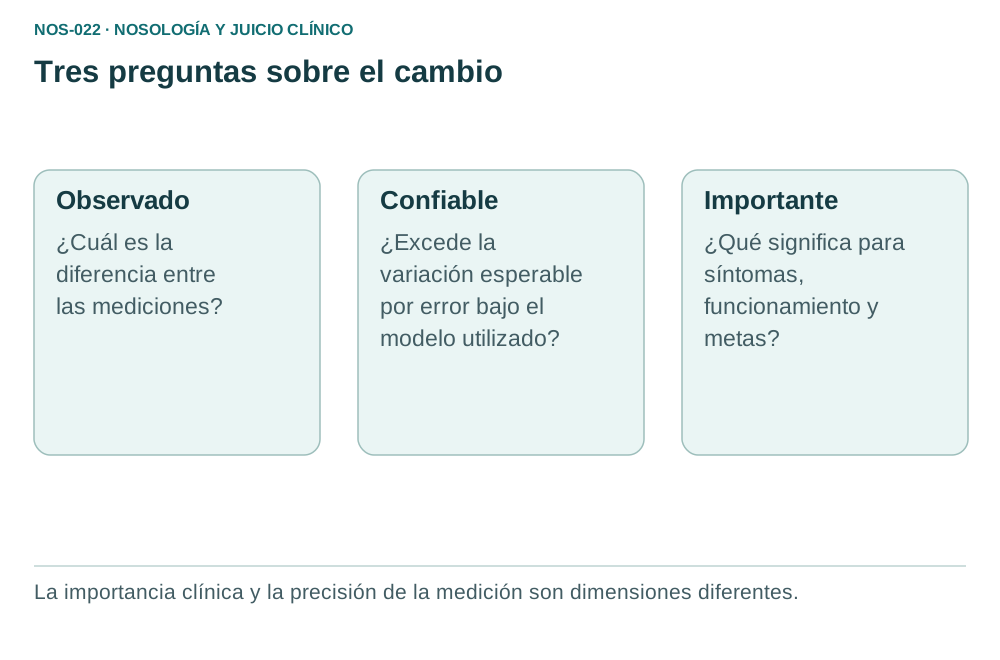
Figura 2. Distinciones originales para interpretar evolución. Los umbrales dependen del instrumento, de la población y de la finalidad; no se ofrece una cifra universal.
Síntomas, funcionamiento y recuperación
La mejoría sintomática es un resultado relevante, pero no agota la recuperación. La participación en actividades depende también de oportunidades, apoyos y barreras. Una persona puede presentar síntomas residuales y recuperar roles importantes; otra puede reducir síntomas y seguir con dificultades considerables. Deben describirse ambos dominios, sin exigir que evolucionen de forma idéntica.
WHODAS 2.0 ofrece una evaluación estandarizada de dificultades en dominios de funcionamiento, vinculada al marco de la Clasificación Internacional del Funcionamiento. Existen versiones y modalidades de administración diferentes, cuya selección y puntuación deben seguir el manual OMS, 2010. No es una escala etiológica ni permite deducir automáticamente qué trastorno causa cada limitación.
Si el paciente refiere que no volvió al trabajo, debe explorarse por qué. Puede persistir fatiga, existir un conflicto laboral, no haber un puesto disponible o haberse modificado la exigencia del cargo. Una medida de funcionamiento resume parte de esa situación, mientras que la entrevista permite identificar condiciones que orientan intervenciones concretas.
Las metas personales pueden incorporarse junto con instrumentos estandarizados. «Retomar una actividad semanal elegida» aporta un resultado observable, aunque no reemplace medidas comparables cuando estas sean necesarias. Debe evitarse presentar como fracaso clínico una meta no alcanzada por barreras externas que el tratamiento no ha abordado.
Medición y necesidades de seguridad
Una respuesta sobre pensamientos de muerte o autolesión requiere exploración clínica directa. Debe precisarse su significado, actualidad, características y necesidades de protección. Un total bajo no invalida una respuesta relevante y un total elevado no determina por sí mismo la urgencia. La lectura de seguridad no puede delegarse a una suma global de síntomas.
NICE indica que las escalas de riesgo no deben utilizarse para predecir suicidio o repetición de autolesión ni para decidir quién recibe tratamiento o es dado de alta. Recomienda centrar la evaluación en necesidades y seguridad, con formulación clínica apropiada NICE, 2022. Esta recomendación no equivale a prohibir toda pregunta estructurada; delimita usos predictivos y decisionales inadecuados.
En el caso inicial, corresponde revisar el ítem pertinente y realizar la evaluación necesaria, independientemente de cómo se clasifique el total de 17. Si la respuesta fue omitida, no debe interpretarse como negativa. Si el paciente aclara un significado diferente del supuesto por el evaluador, la aclaración debe registrarse sin borrar la necesidad de comprender el contexto.
Atención basada en mediciones
La atención basada en mediciones implica recoger, revisar y utilizar resultados para ajustar el cuidado. El ensayo de Guo y colaboradores comparó durante veinticuatro semanas un modelo con decisiones apoyadas en guías y escalas frente a atención estándar en 120 pacientes ambulatorios con depresión mayor. Encontró mejores resultados de respuesta y remisión en el grupo de medición, dentro de un protocolo y opciones farmacológicas definidos Guo et al., 2015.
Ese estudio no demuestra que entregar cuestionarios sin retroalimentación mejore por sí solo la atención, ni que el mismo efecto se reproduzca en cualquier trastorno o servicio. La intervención incluye un proceso de decisiones. Para trasladarlo a la práctica se necesita saber quién revisa los resultados, cuándo se discuten y qué ocurre ante deterioro o efectos adversos.
Un circuito factible puede comenzar con una medida basal, repetición en intervalos justificados y revisión conjunta durante la consulta. Debe incluir síntomas, funcionamiento y tolerabilidad según el problema. No es necesario aplicar muchas escalas en cada visita: la selección responde a objetivos y debe evitar una carga que impida completar la evaluación clínica.
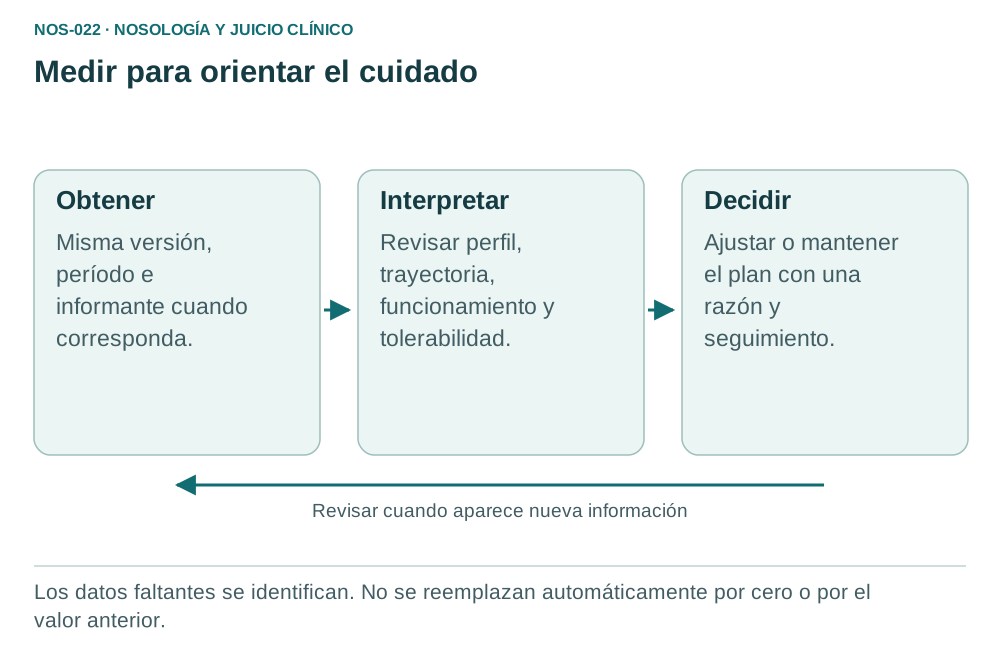
Figura 3. Circuito original de uso clínico. La medición termina en una interpretación y una decisión documentada, que también puede ser mantener el plan con seguimiento.
Ejercicio de seguimiento y discordancia
En un ejemplo hipotético, una paciente completa la misma escala en tres controles. El total disminuye, pero refiere más somnolencia y menor capacidad para cuidar a sus hijos. Concluir «respuesta favorable» sin matices confundiría mejoría de un dominio con beneficio global. Debe revisarse qué síntomas disminuyeron, qué dificultades aparecieron y si están relacionadas con el tratamiento o con otras condiciones.
El plan puede requerir modificar una intervención, investigar un efecto adverso o establecer apoyos, según la evaluación. No se deduce automáticamente de la curva. La discusión con la paciente permite conocer si la mejoría sintomática compensa las dificultades nuevas desde su perspectiva y qué alternativas son clínicamente razonables.
Otro escenario es un aumento de puntuación después de cambiar de versión o de modalidad de administración. Antes de atribuirlo a recaída, debe examinarse la comparabilidad. Esto no significa descartar el deterioro: se revisan tanto la medición como el estado clínico. La incertidumbre sobre el instrumento y la posibilidad de un cambio real pueden coexistir.
Si una medición no se realizó, la gráfica debe mostrar un dato faltante. No corresponde copiar el puntaje anterior ni asignar cero para completar la serie. Una línea continua entre observaciones distantes puede sugerir una evolución que no fue observada; el registro necesita distinguir mediciones reales de interpolaciones gráficas.
Revisar un instrumento antes de incorporarlo al servicio
La selección institucional puede organizarse mediante una ficha breve. Debe identificar nombre y versión, constructo, población estudiada, propósito propuesto, forma de administración, reglas para datos faltantes y fuente del manual. También conviene registrar qué evidencia respalda la interpretación longitudinal, porque un estudio de detección transversal no responde automáticamente cuánto cambio individual puede interpretarse.
Si se desea comparar resultados entre profesionales, debe acordarse cómo se aplicará y registrará el instrumento. Las diferencias de instrucciones, período o asistencia pueden producir variación ajena al estado clínico. Un procedimiento común facilita comparar, pero no debe impedir documentar adaptaciones necesarias. La comparabilidad se evalúa; no se presume por utilizar el mismo nombre de escala.
El diseño del registro también importa. Una ficha que muestra solo el último total puede ocultar trayectoria y perfil. Resulta más informativo conservar fecha, puntuación, cambios de versión y una interpretación clínica breve. Cuando se muestran gráficos, los ejes deben estar identificados y la dirección del puntaje debe ser explícita: en algunas medidas un valor mayor indica más dificultades y en otras puede indicar mejor estado.
Un equipo podría decidir inicialmente una escala de síntomas y una medida de funcionamiento para un programa específico. Antes de extender la batería debería comprobar si los resultados se revisan durante las consultas y si aportan decisiones útiles. La ausencia de uso puede indicar problemas de integración del proceso y no necesariamente que el instrumento carezca de valor. Agregar más formularios sin resolver ese problema aumenta la carga sin aclarar el cuidado.
La evaluación del programa debe distinguir resultados clínicos de cumplimiento administrativo. Tener un cuestionario completado en cada visita demuestra registro, no mejoría ni buena interpretación. A su vez, una proporción de formularios faltantes puede responder a problemas de accesibilidad, idioma o flujo asistencial que necesitan corrección. La auditoría puede examinar esas razones antes de atribuirlas a pacientes o profesionales.
Finalmente, la elección debe revisarse cuando cambia la población atendida o el propósito. Un instrumento útil para seguimiento ambulatorio puede no ser suficiente para una evaluación pericial o una urgencia. Explicitar esa frontera protege la calidad de las decisiones y permite utilizar las mediciones donde realmente aportan información.
Aplicación al caso inicial
Los 17 puntos del PHQ-9 respaldan una carga relevante de síntomas según ese instrumento. El siguiente paso es caracterizar el episodio, el curso y las alternativas, evaluar funcionamiento y necesidades de seguridad, y acordar el plan. No corresponde inferir automáticamente depresión unipolar, descartar causas concurrentes o seleccionar tratamiento solo por el total.
Si el PHQ-9 resulta pertinente para el seguimiento, puede conservarse como medida basal, registrando versión y condiciones. La repetición debe acompañarse de revisión clínica y de resultados que importen a la paciente. La conclusión puede expresar simultáneamente que disminuyeron síntomas, persisten dificultades funcionales y se requiere un ajuste del cuidado.
Autoevaluación razonada
¿Un instrumento validado sirve para cualquier finalidad? No. La evidencia debe corresponder a la interpretación, población y condiciones de uso.
¿Dos puntajes iguales representan estados idénticos? No. Pueden ocultar perfiles distintos y cambios opuestos en síntomas relevantes.
¿Una diferencia de puntos demuestra recuperación? No. Debe interpretarse según error de medición, importancia clínica, funcionamiento y trayectoria.
¿Una discrepancia con la entrevista invalida la escala? No automáticamente. Obliga a revisar ambas fuentes, sus períodos, dominios y condiciones de obtención.
Referencias seleccionadas
- Kroenke K, Spitzer RL, Williams JBW. The PHQ-9: validity of a brief depression severity measure. Journal of General Internal Medicine. 2001;16(9):606–613. Estudio y DOI 10.1046/j.1525-1497.2001.016009606.x.
2. Negeri ZF, Levis B, Sun Y, et al. Accuracy of the Patient Health Questionnaire-9 for screening to detect major depression: updated systematic review and individual participant data meta-analysis. BMJ. 2021;375:n2183. Metaanálisis y DOI 10.1136/bmj.n2183.
3. Mokkink LB, Terwee CB, Patrick DL, et al. The COSMIN checklist for assessing the methodological quality of studies on measurement properties of health status measurement instruments: an international Delphi study. Quality of Life Research. 2010;19:539–549. Artículo y DOI 10.1007/s11136-010-9606-8.
4. Jacobson NS, Truax P. Clinical significance: a statistical approach to defining meaningful change in psychotherapy research. Journal of Consulting and Clinical Psychology. 1991;59(1):12–19. Artículo y DOI 10.1037/0022-006X.59.1.12.
5. Üstün TB, Kostanjsek N, Chatterji S, Rehm J, eds. Measuring Health and Disability: Manual for WHO Disability Assessment Schedule WHODAS 2.0. World Health Organization; 2010. Instrumento, manual y versiones de la OMS.
6. National Institute for Health and Care Excellence. Self-harm: assessment, management and preventing recurrence. NG225; 2022. Recomendaciones de NICE, sección 1.6.
7. Guo T, Xiang YT, Xiao L, et al. Measurement-Based Care Versus Standard Care for Major Depression: A Randomized Controlled Trial With Blind Raters. American Journal of Psychiatry. 2015;172(10):1004–1013. Ensayo y DOI 10.1176/appi.ajp.2015.14050652.
Jonathan Alarcón C., ed. Instrumentos, tamizajes, escalas de gravedad y medición de resultados. Docencia en Psiquiatría. Revisión 24.09.2026. https://portal-docencia-psiquiatria-uc-hlf.pages.dev/becados/nosologia-juicio-clinico/instrumentos-tamizajes-escalas-de-gravedad-y-medicion-de-resultados/