Objetivos de aprendizaje
El residente podrá distinguir consistencia de clasificación, respaldo de las inferencias y utilidad asistencial; interpretar un coeficiente de acuerdo en relación con su diseño; evaluar validadores sin confundir asociaciones grupales con pruebas individuales; y analizar las consecuencias de una decisión diagnóstica. La clase incluye cálculos didácticos y un procedimiento para revisar desacuerdos entre profesionales.
Desacuerdo diagnóstico y preguntas diferentes
Dos psiquiatras evalúan a una misma paciente. Uno propone un trastorno bipolar y el otro considera una presentación depresiva con dificultades persistentes de regulación afectiva. En este caso hipotético, el desacuerdo podría deberse a distinta información, a interpretación diferente de los mismos datos o a aplicación inconsistente de requisitos. La primera tarea consiste en identificar cuál de estas situaciones está ocurriendo.
La confiabilidad pregunta si una evaluación produce resultados consistentes bajo condiciones especificadas. La validez pregunta si las interpretaciones o clasificaciones están justificadas por evidencia pertinente. La utilidad clínica examina si ayudan a cumplir objetivos asistenciales. Las consecuencias incluyen efectos sobre tratamiento, acceso, comunicación y experiencia del paciente. Una propiedad no demuestra automáticamente las demás.
El desacuerdo tampoco equivale a incertidumbre total. Ambos profesionales pueden reconocer el mismo síndrome actual y discrepar acerca de su ubicación longitudinal. También pueden coincidir en las necesidades inmediatas aunque difieran en la categoría. Separar los niveles permite dirigir la revisión hacia información discriminativa y evitar que la discusión se reduzca a preferir una etiqueta.
Formas de confiabilidad
La confiabilidad interevaluador estudia el acuerdo entre observadores. Su interpretación depende de si ambos presenciaron la misma entrevista, revisaron un registro común o entrevistaron de manera independiente. El primer diseño controla diferencias en obtención de información; el último incorpora variación de preguntas, respuestas y condiciones. Ambos pueden ser pertinentes, pero responden a preguntas distintas.
La confiabilidad test–retest evalúa estabilidad entre mediciones separadas cuando se espera que el fenómeno permanezca suficientemente estable. En clínica, un cambio puede reflejar error de medición, información nueva o evolución real. Cuanto mayor sea el intervalo, más importante es examinar tratamiento y acontecimientos intercurrentes. Un resultado diferente no debe clasificarse automáticamente como falta de confiabilidad del instrumento.
La consistencia interna describe relaciones entre ítems bajo determinados supuestos de medición. No equivale a acuerdo diagnóstico ni demuestra que una escala mida un solo proceso. Ítems muy similares pueden elevar un coeficiente y, a la vez, cubrir un dominio estrecho. La elección del estadístico debe corresponder al tipo de datos y a la interpretación prevista.
La confiabilidad es una propiedad de resultados obtenidos con un procedimiento en una población y condiciones determinadas. Es impreciso afirmar que un diagnóstico «tiene» un valor fijo de confiabilidad independiente del contexto. Formación, complejidad de casos, acceso a antecedentes y claridad de reglas pueden modificar el acuerdo. Por eso, los estudios deben describir cómo se obtuvo la estimación.
Acuerdo observado y coeficiente kappa
El porcentaje de acuerdo informa cuántas clasificaciones coinciden. Puede ser alto cuando casi todos los casos se asignan a una misma categoría. El coeficiente kappa compara el acuerdo observado con el esperado bajo un modelo basado en las frecuencias marginales de los evaluadores. Se expresa como κ = (Po − Pe) / (1 − Pe), donde Po es el acuerdo observado y Pe el acuerdo esperado por ese modelo.
La expresión «corregido por azar» debe entenderse con cautela. Pe no demuestra que los clínicos hayan respondido aleatoriamente; es una cantidad calculada según el modelo. La prevalencia observada y las diferencias entre las proporciones de clasificación influyen en el resultado. Por ello, un coeficiente debe leerse junto con la tabla de datos, el intervalo de confianza y el diseño.
Considérese este ejemplo exclusivamente didáctico: dos evaluadores clasifican cien casos como presencia o ausencia de una condición. Coinciden en treinta positivos y cincuenta negativos; discrepan en veinte. Cada uno clasifica cuarenta positivos y sesenta negativos. El acuerdo observado es 0,80 y el esperado es 0,40 × 0,40 + 0,60 × 0,60 = 0,52. Por tanto, κ = (0,80 − 0,52) / (1 − 0,52), aproximadamente 0,58.
| Evaluador A / Evaluador B | B positivo | B negativo | Total |
|---|---|---|---|
| A positivo | 30 | 10 | 40 |
| A negativo | 10 | 50 | 60 |
| Total | 40 | 60 | 100 |
El cálculo no identifica quién tiene razón. Ambos podrían estar aplicando de forma similar una regla inadecuada. Tampoco informa directamente sobre sensibilidad o especificidad, porque no se ha introducido una referencia independiente. Para esos parámetros se necesita definir cómo se establece la condición de interés y reconocer las limitaciones de esa referencia.
Leer estudios de campo sin comparaciones indebidas
Los ensayos de campo del DSM-5 estudiaron diagnósticos seleccionados mediante entrevistas realizadas por clínicos diferentes en ocasiones separadas. Ese diseño incorpora variaciones propias de obtener información nuevamente y no solamente de interpretar un relato común (Regier et al., 2013). Sus resultados deben vincularse a las categorías y condiciones estudiadas, sin atribuir un único coeficiente a todo el manual.
El estudio internacional de desarrollo de la CIE-11 utilizó evaluaciones conjuntas con dos calificadores en servicios de salud mental de trece países. En los diagnósticos analizados, las estimaciones publicadas abarcaron valores diferentes según categoría, con sus intervalos de confianza (Reed et al., 2018a). Compartir entrevista limita una fuente de variación y permite estudiar otras.
Comparar directamente un coeficiente de entrevistas independientes con otro de entrevista conjunta puede atribuir al sistema una diferencia debida al diseño. También importan selección de pacientes, distribución de diagnósticos, entrenamiento y disponibilidad de antecedentes. Una comparación válida necesita condiciones suficientemente comparables o un análisis explícito de esas diferencias.
Las etiquetas cualitativas aplicadas a kappa, como moderado o excelente, tampoco resuelven por sí solas la relevancia clínica. Debe considerarse qué decisiones dependen del diagnóstico y qué errores producen daño. Un coeficiente promedio puede ocultar problemas en una frontera específica o en un subgrupo. Revisar las discrepancias concretas suele aportar más información práctica que un adjetivo aislado.
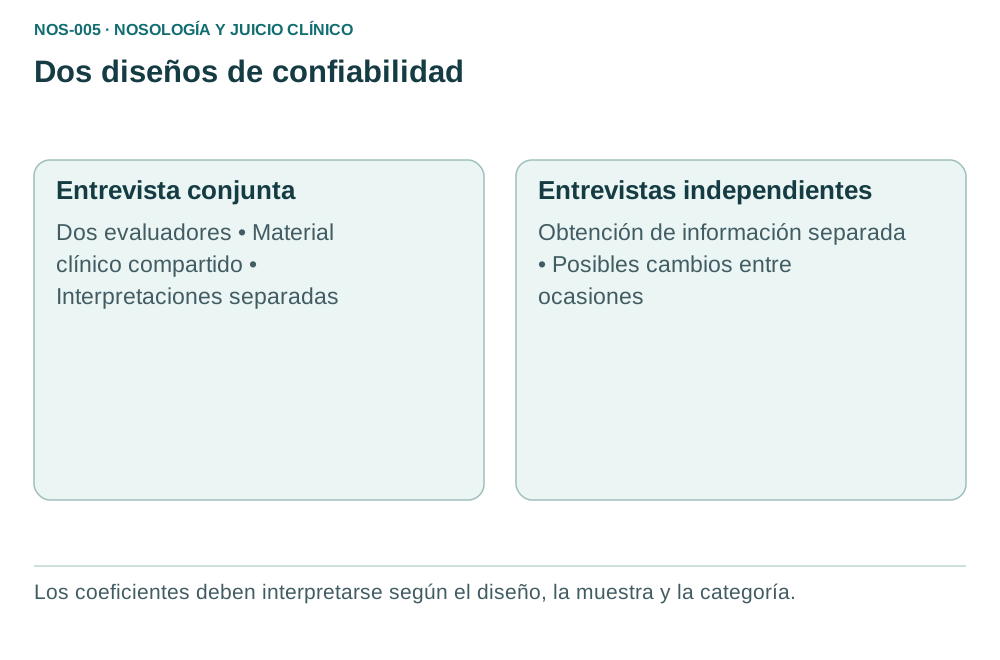
Figura 1. Dos diseños de evaluación del acuerdo. Elaboración docente original. Las fuentes de variación no son idénticas; los coeficientes resultantes requieren interpretación dentro de cada diseño.
Validez y evidencia pertinente
La validez se refiere al respaldo de una interpretación o clasificación. Antes de evaluarla debe precisarse la afirmación: reconocer un patrón clínico, anticipar evolución, distinguir grupos o identificar un mecanismo. La evidencia adecuada para una de estas funciones puede ser insuficiente para otra. No existe un resultado único que valide simultáneamente todos los usos de una categoría.
Robins y Guze propusieron un programa de validación que integraba descripción clínica, estudios de laboratorio, delimitación respecto de otros trastornos, seguimiento y estudios familiares. Su trabajo fue decisivo para organizar investigación diagnóstica (Robins y Guze, 1970). La relevancia histórica del programa no obliga a aceptar todas sus conclusiones originales ni convierte cada validador en una prueba definitiva.
Un validador debe aportar información que no sea una simple repetición de la definición. Si se utiliza gravedad de síntomas para formar grupos y luego se observa que los grupos difieren en esos mismos síntomas, se confirma una consecuencia del procedimiento. Para justificar inferencias adicionales hacen falta resultados independientes o diseños que contrasten predicciones nuevas.
La independencia también se relaciona con los evaluadores. Si quien determina la referencia conoce el resultado de la prueba, puede incorporarlo inadvertidamente a su juicio. El cegamiento, la descripción del procedimiento y el análisis de discrepancias ayudan a evaluar ese riesgo. Cuando no existe un patrón etiológico de referencia, la transparencia sobre cómo se construyó la comparación resulta especialmente importante.
Evidencia convergente y discriminante
La convergencia examina si distintas observaciones se relacionan de la manera esperada cuando pretenden medir aspectos del mismo constructo. La discriminación examina si se distinguen de constructos diferentes cuando la teoría lo requiere. Una correlación elevada no siempre es favorable: puede indicar que dos medidas supuestamente distintas captan contenido muy similar.
En psiquiatría, síntomas compartidos y factores generales pueden producir asociaciones entre diagnósticos. La interpretación requiere comparar modelos alternativos. Una agrupación familiar, por ejemplo, puede apoyar vulnerabilidad relacionada sin demostrar que las fronteras categoriales sean exactas. Un correlato cognitivo puede asociarse con gravedad general o tratamiento, en lugar de ser específico de la categoría investigada.
La respuesta terapéutica es otro ejemplo. Si una intervención beneficia varias presentaciones, la mejoría no identifica necesariamente una entidad específica. Para usar respuesta como evidencia discriminante se necesita estudiar diferencias pertinentes, condiciones de exposición y explicaciones alternativas. El hecho de que un tratamiento sea eficaz no establece por sí mismo una etiología única para quienes responden.
La evidencia debe acumularse de manera crítica y revisable. Una asociación no replicada, un estudio pequeño o una muestra muy seleccionada tienen un alcance limitado. Resultados negativos también pueden ser informativos, aunque requieren potencia y medición adecuadas. La validación implica comparar expectativas con observaciones y modificar la interpretación cuando el conjunto de evidencia lo exige.
Distintas concepciones de validez
En nosología, algunas concepciones privilegian límites naturales; otras enfatizan estructura psicométrica, mecanismos o capacidad de sostener inferencias. Kendell y Jablensky distinguieron validez y utilidad desde una discusión centrada en la delimitación de entidades (Kendell y Jablensky, 2003). Esa concepción debe identificarse cuando se afirma que una categoría carece de validez: la conclusión no significa necesariamente que toda información asociada sea falsa.
Zautra analizó cómo marcos contemporáneos pueden emplear estándares de validación diferentes, dificultando comparaciones directas. Su propuesta señala un problema metodológico y filosófico acerca de qué cuenta como evidencia y qué se intenta validar (Zautra, 2025). El argumento no demuestra que todos los sistemas sean equivalentes ni que la evaluación empírica resulte imposible.
Para discutir dos clasificaciones, conviene formular una pregunta compartida. Si una organiza mejor covariación y otra orienta mejor ciertas decisiones, no están compitiendo necesariamente por el mismo resultado. Es posible comparar cada función y después examinar compromisos entre ellas. Declarar un sistema superior exige especificar en qué dimensión y bajo qué condiciones.
En clínica, esta precisión evita extremos. Un profesional no debería exigir un biomarcador exclusivo para reconocer cualquier trastorno, ni considerar que utilidad comunicativa demuestra una entidad causal homogénea. La evaluación debe mantener el nivel de afirmación correspondiente y actualizarlo según nuevas pruebas. La clasificación es revisable sin que cada revisión invalide todas las aplicaciones anteriores.
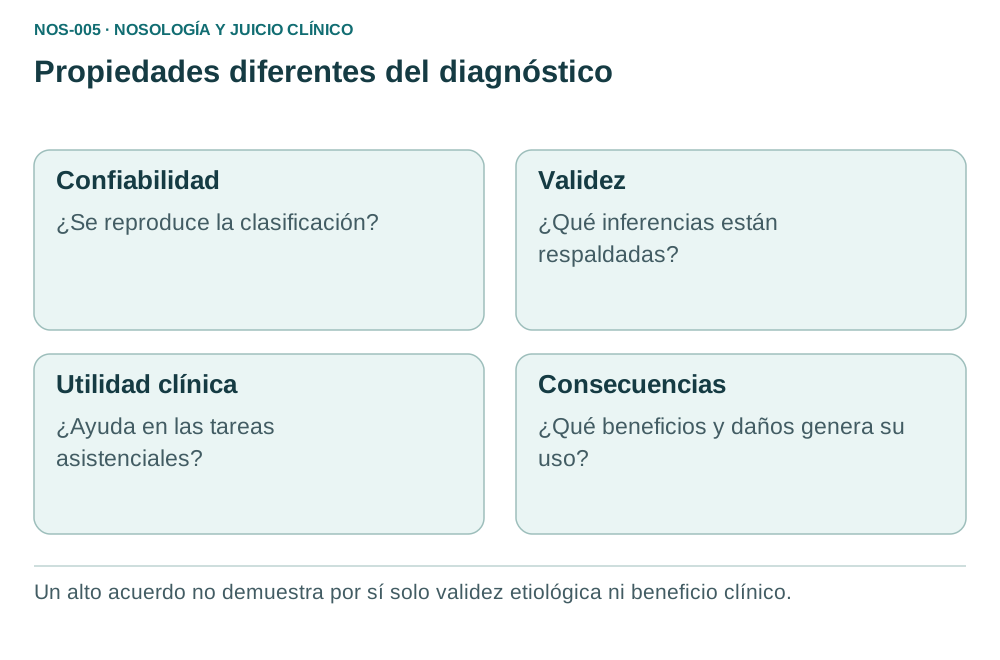
Figura 2. Propiedades diferentes de un sistema diagnóstico. Las relaciones entre ellas deben investigarse; una propiedad favorable no garantiza lógicamente el cumplimiento de las demás.
Utilidad clínica como objeto de investigación
La utilidad clínica se refiere a la contribución de una clasificación a tareas concretas: comunicación, evaluación, elección de intervenciones y seguimiento. Debe estudiarse para usuarios y entornos definidos. Una clasificación comprensible para especialistas puede resultar difícil de aplicar en atención general; una medida extensa puede ofrecer detalle, pero imponer una carga que limite su uso.
Keeley y colaboradores propusieron un programa empírico para estudiar utilidad clínica durante el desarrollo de la CIE-11, integrando estrategias de campo y evaluación de cómo se utilizan las directrices (Keeley et al., 2016). Esta aproximación evita identificar utilidad exclusivamente con opiniones generales sobre un manual o con su popularidad.
Las valoraciones de clínicos constituyen una fuente de evidencia, aunque no equivalen a demostrar mejores resultados en pacientes. El estudio internacional de utilidad de la CIE-11 examinó evaluaciones de profesionales en servicios de trece países (Reed et al., 2018b). Para afirmar que una clasificación mejora desenlaces se necesitan estudios que midan esos desenlaces y permitan atribuir cambios al uso del sistema.
Una evaluación completa también incluye aceptabilidad para pacientes, claridad de comunicación y posibilidades de implementación. La familiaridad puede influir en preferencias: un sistema conocido puede resultar más fácil aunque otro ofrezca ventajas tras entrenamiento. Por ello, conviene diferenciar desempeño inicial, aprendizaje y uso sostenido, además de considerar recursos y traducción.
Consecuencias y validez de la decisión
Un diagnóstico puede facilitar acceso a atención y, al mismo tiempo, tener efectos no deseados. Su evaluación requiere considerar falsos positivos, falsos negativos, tratamiento innecesario, retraso asistencial y consecuencias comunicativas. El balance depende del contexto y de la acción que se asocia a la clasificación. No todas las decisiones requieren el mismo grado de certeza.
Las consecuencias no determinan por sí solas la verdad de una afirmación. Que una etiqueta sea beneficiosa no demuestra que la clasificación sea correcta; que resulte incómoda no demuestra que sea falsa. Sin embargo, los posibles daños influyen en cuánto debe investigarse antes de actuar y en cómo se comunica y revisa la conclusión.
Una decisión con efectos duraderos exige conservar evidencia, incertidumbre y fundamento. Si se utiliza un diagnóstico para justificar una restricción, la categoría no reemplaza la evaluación específica del problema que motiva esa restricción. Capacidad, riesgo y funcionamiento deben examinarse según sus propias preguntas, sin deducirse automáticamente del nombre del trastorno.
El seguimiento de consecuencias puede revelar errores de implementación. Una categoría podría ser útil en investigación y generar confusión al trasladarse sin formación a otro entorno. También pueden existir desigualdades en acceso a evaluación o en interpretación de síntomas. Revisarlas exige datos sobre procedimientos y resultados, evitando atribuir toda diferencia observada a características de los pacientes.
Un procedimiento para revisar el desacuerdo
Primero se comparan las fuentes disponibles para cada evaluador. Si uno obtuvo antecedentes familiares y el otro no, las conclusiones no se basaron en la misma información. Después se comparan descripciones: qué se entendió por aumento de energía, episodicidad o cambio basal. Solo entonces puede evaluarse si hubo aplicación distinta de reglas a hechos realmente compartidos.
En el caso inicial, se reconstruyen períodos de cambio y funcionamiento entre ellos. Se aclara si las fluctuaciones fueron breves y reactivas, si existieron períodos sostenidos de activación y qué información los corrobora. Estos datos pueden modificar hipótesis, pero no deben transformarse en una regla simplificada según la cual una sola característica separa todas las presentaciones.
El siguiente paso es identificar qué dato tendría mayor valor discriminativo. Puede tratarse de un registro de hospitalización, una entrevista con un informante o una cronología más precisa. La tarea debe ser concreta y proporcional. Acumular exámenes sin una pregunta relevante no resuelve necesariamente un desacuerdo originado en interpretación del curso.
Finalmente, se revisa qué decisión cambiaría según la conclusión. Si las necesidades inmediatas son compartidas, puede acordarse un plan mientras se obtiene información. Si una intervención depende de una hipótesis específica, debe explicitarse el beneficio esperado, los riesgos y la incertidumbre. El desacuerdo puede quedar documentado sin impedir continuidad de atención.
| Fuente posible de desacuerdo | Pregunta de revisión | Acción pertinente |
|---|---|---|
| Información diferente | ¿Ambos conocían los mismos antecedentes? | Completar y contrastar fuentes |
| Fenomenología diferente | ¿Se atribuyó el mismo significado al hallazgo? | Reexplorar con ejemplos concretos |
| Reglas diferentes | ¿Se utilizó el mismo sistema y versión? | Consultar requisitos pertinentes |
| Cambio real | ¿La presentación evolucionó entre entrevistas? | Reconstruir temporalidad y tratamiento |
| Inferencia diferente | ¿Qué alternativa explica mejor los datos? | Comparar argumentos y condiciones de revisión |
Cómo leer un estudio diagnóstico
La pregunta inicial es quiénes fueron incluidos. Una muestra compuesta por casos muy definidos y controles sin problemas puede sobreestimar el rendimiento que se obtendrá frente a presentaciones ambiguas. El entorno, las exclusiones y la distribución de gravedad determinan a quiénes se puede generalizar. El número total de participantes no reemplaza esa evaluación.
Después se revisan el procedimiento y la referencia. Debe conocerse qué información recibió cada evaluador, si hubo cegamiento y cuánto tiempo transcurrió entre mediciones. Cuando la referencia es consenso experto, conviene examinar cómo se obtuvo y si incorporó la prueba evaluada. El consenso puede mejorar integración de información, pero no constituye infalibilidad.
Los resultados deben incluir incertidumbre. Un valor puntual con pocos casos puede ser inestable, especialmente en diagnósticos infrecuentes. Los intervalos de confianza permiten valorar esa precisión. También importa revisar datos faltantes y exclusiones posteriores, porque pueden alterar la composición de la muestra y el significado de la estimación.
La última pregunta es qué cambiaría en la práctica. Un incremento estadístico pequeño puede no modificar ninguna decisión; una herramienta breve podría ser útil aunque no maximice detalle. Debe explicitarse el objetivo asistencial y comparar alternativas reales. La decisión de implementar necesita considerar rendimiento, carga, formación y consecuencias previsibles.
Ejercicio de auditoría de un servicio
Un servicio detecta que dos equipos asignan proporciones distintas de un diagnóstico. Antes de interpretar la diferencia como error, debe examinar si atienden poblaciones similares. Uno puede recibir derivaciones complejas y el otro primeros contactos. También pueden variar acceso a antecedentes, momento de evaluación y duración del seguimiento. La comparación necesita denominadores y condiciones explícitas.
Puede seleccionarse una muestra de casos para revisión independiente, utilizando reglas y fuentes definidas. Se registran discrepancias por requisito y no solo por etiqueta final. Si la principal diferencia aparece en duración, la intervención formativa será distinta de aquella necesaria cuando el problema es reconocer un fenómeno. La auditoría debe generar acciones relacionadas con el hallazgo concreto.
Después de una modificación, se repite la evaluación en condiciones comparables y se examinan consecuencias. Mayor acuerdo puede ser favorable, pero conviene comprobar que no se haya logrado mediante simplificación excesiva o exclusión de casos difíciles. También se puede revisar si mejoró comunicación, seguimiento o detección de información faltante. El objetivo es mejorar procesos y decisiones, no obtener un coeficiente aislado.
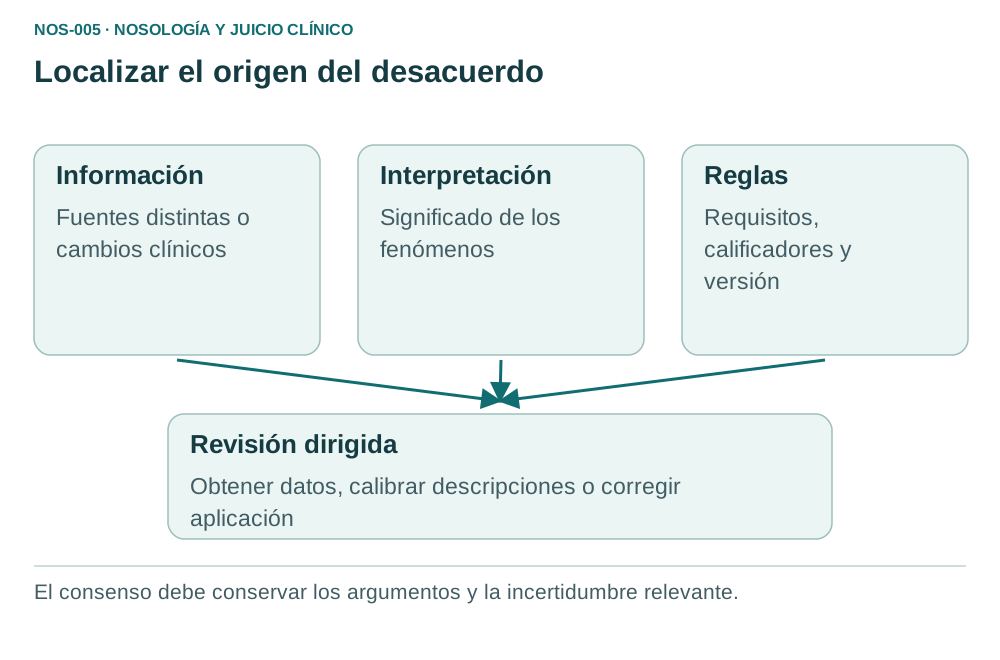
Figura 3. Revisión de desacuerdos diagnósticos. El esquema orienta una auditoría clínica y no sustituye instrumentos de evaluación o protocolos de investigación.
Segundo ejercicio sobre acuerdo y frecuencia
Considérese otra muestra hipotética de cien personas. Cada evaluador clasifica cinco casos como positivos, pero solamente coinciden en uno de esos casos. Hay noventa y un acuerdos negativos y ocho discrepancias. El acuerdo global es del 92 %, aunque la coincidencia entre las clasificaciones positivas es limitada. Las proporciones marginales producen un acuerdo esperado de 0,05 × 0,05 + 0,95 × 0,95 = 0,905.
En este ejemplo, κ = (0,92 − 0,905) / (1 − 0,905), aproximadamente 0,16. El contraste con el ejercicio anterior muestra por qué el porcentaje global puede resultar insuficiente cuando una categoría es infrecuente. No se trata de elegir el número que parece más favorable: ambos describen aspectos del mismo conjunto de datos y deben interpretarse conjuntamente.
El análisis puede complementarse con acuerdo positivo y negativo, utilizando definiciones explícitas. Lo importante para la discusión clínica es reconocer dónde se concentran las discrepancias. Si los pocos pacientes que podrían requerir una intervención específica reciben clasificaciones muy diferentes, la elevada coincidencia en los negativos no resuelve el problema asistencial. La revisión debe concentrarse en esos casos y en los requisitos que generaron desacuerdo.
Ninguno de estos ejemplos permite establecer un umbral universal de calidad. Las consecuencias de una discrepancia, la precisión de la estimación y el propósito del procedimiento deben considerarse antes de decidir si el rendimiento es aceptable. Además, una muestra de cien casos puede ser insuficiente para estimar con precisión acuerdo en condiciones raras. El tamaño necesario depende de la pregunta y de la distribución esperada.
Separar mejora de medición y mejora de atención
Un servicio puede aumentar consistencia mediante entrenamiento y acceso a una entrevista estructurada. Ese cambio puede facilitar comunicación y comparación, pero todavía debe comprobarse qué ocurre con decisiones y resultados. Una evaluación más uniforme puede seguir omitiendo información importante si el procedimiento no contempla adecuadamente el contexto o el curso.
También puede mejorar la atención sin cambiar inmediatamente la clasificación. Registrar con precisión necesidades de autocuidado, efectos adversos o barreras de acceso puede modificar el plan mientras persiste incertidumbre diagnóstica. Eso no vuelve irrelevante el diagnóstico; muestra que los resultados asistenciales dependen de más componentes que la etiqueta y que una auditoría debe seleccionar medidas acordes con su objetivo.
Por último, una mejora aparente puede deberse a cambios en los casos atendidos o en la disponibilidad de recursos. Si después de introducir un sistema disminuyen hospitalizaciones, no puede atribuirse todo el efecto a la clasificación sin examinar otras modificaciones. La evaluación de impacto requiere un diseño que permita comparar explicaciones y sostener una conclusión proporcional a la evidencia.
Autoevaluación razonada
1. ¿Un acuerdo del 80 % demuestra exactitud diagnóstica del 80 %? No. El acuerdo compara evaluadores, mientras la exactitud requiere una referencia pertinente. Dos evaluadores pueden coincidir en una conclusión incorrecta o discrepar por información diferente.
2. ¿Un kappa mayor prueba que un manual es superior? No sin examinar diseño, población, categoría e incertidumbre. Las entrevistas conjuntas y las independientes incorporan fuentes distintas de variación. La comparación debe especificar qué propiedad se está evaluando.
3. ¿Una diferencia biológica grupal valida un diagnóstico individual? No necesariamente. Deben estudiarse superposición, especificidad, factores alternativos y rendimiento en individuos. La asociación puede apoyar una línea de investigación sin constituir una prueba clínica.
4. ¿Cómo se resuelve un desacuerdo en el caso inicial? Comparando información, descripción de fenómenos, cronología y reglas aplicadas; luego se identifica qué dato podría discriminar hipótesis y qué decisiones dependen de él. El acuerdo por votación no reemplaza ese análisis.
Referencias seleccionadas
- Regier DA, Narrow WE, Clarke DE, et al. DSM-5 field trials in the United States and Canada, Part II: test-retest reliability of selected categorical diagnoses. Am J Psychiatry. 2013;170:59–70. doi:10.1176/appi.ajp.2012.12070999.
2. Reed GM, Sharan P, Rebello TJ, et al. The ICD-11 developmental field study of reliability of diagnoses of high-burden mental disorders: results among adult patients in mental health settings of 13 countries. World Psychiatry. 2018;17:174–186. doi:10.1002/wps.20524.
3. Robins E, Guze SB. Establishment of diagnostic validity in psychiatric illness: its application to schizophrenia. Am J Psychiatry. 1970;126:983–987. doi:10.1176/ajp.126.7.983.
4. Kendell R, Jablensky A. Distinguishing between the validity and utility of psychiatric diagnoses. Am J Psychiatry. 2003;160:4–12. doi:10.1176/appi.ajp.160.1.4.
5. Zautra N. Psychiatry’s new validity crisis: the problem of disparate validation. Philosophy of Science. 2025;92:646–665. doi:10.1017/psa.2024.71.
6. Keeley JW, Reed GM, Roberts MC, et al. Developing a science of clinical utility in diagnostic classification systems: field study strategies for ICD-11 mental and behavioral disorders. Am Psychol. 2016;71:3–16. doi:10.1037/a0039972.
7. Reed GM, Keeley JW, Rebello TJ, et al. Clinical utility of ICD-11 diagnostic guidelines for high-burden mental disorders: results from mental health settings in 13 countries. World Psychiatry. 2018;17:306–315. doi:10.1002/wps.20581.
Jonathan Alarcón C., ed. Confiabilidad, validez, utilidad clínica y consecuencias del diagnóstico. Docencia en Psiquiatría. Revisión 23.09.2026. https://portal-docencia-psiquiatria-uc-hlf.pages.dev/becados/nosologia-juicio-clinico/confiabilidad-validez-utilidad-clinica-y-consecuencias-del-diagnostico/